GPT Image 2 是 OpenAI 于 2026 年 4 月 21 日发布的最新 AI 图像生成模型,也是 OpenAI 首个内置推理功能的图像模型。它通过规划布局、参考网络信息以及在生成最终结果前检查自身输出来生成图像。
核心要点
- 该模型使用一种“思考模式”,使其在生成图像前可以进行规划、搜索和自我检查,这让它比早期模型精确得多。
- 文本渲染能力得到显著提升,混合脚本和多语言布局现在能生成可用的专业级结果。
- 它最适合作为设计素材工具,而非创意探索引擎。模糊的提示词会产生较差的结果。
- “思考模式”会带来明显的延迟,这使其在处理大批量或批量生成的工作流时不太实用。
- 在早期用户生成的内容中,纵向图像以 53.5% 的比例占据主导,表明其在社交媒体和垂直内容格式中得到了广泛应用。
- 它已原生集成于 ChatGPT,可通过 API 使用,并正扩展到 Microsoft Copilot 和 Apple Intelligence。
为何这个模型的工作方式与众不同
大多数 AI 图像模型的工作方式是接收你的文本提示词,然后立即将其转换为像素。但这个模型有所不同。它采用了一种带有内置推理层的自回归架构,这意味着它在生成前会先“思考”。它能够规划布局、为确保视觉准确性而引用网络参考资料,并在你看到最终输出之前进行自我检查。
这种“思考模式”是 AI 图像生成工作方式的一次重大转变。模型不再只是将你的文字与视觉输出进行模式匹配,而是将你的提示词视为一份设计简报并尝试解决它。这使得它在结构化、注重精度的使用场景中表现得格外强大。
早期的用户数据反映了市场的浓厚兴趣。在模型发布后的几天内,一个为期六天的数据收集窗口就从 Twitter/X 捕获了 27,662 条图像记录。使用高峰出现在发布第二天,即 4 月 22 日,随着不同时区的用户相继获得访问权限。在生成的图像中,纵向格式占 53.5%,横向格式占 38.0%,方形格式占 8.6%。59.2% 的图像中出现了人脸,这表明人们正在大量使用它来创作人像、营销内容和以人为中心的设计。
它的最佳应用场景
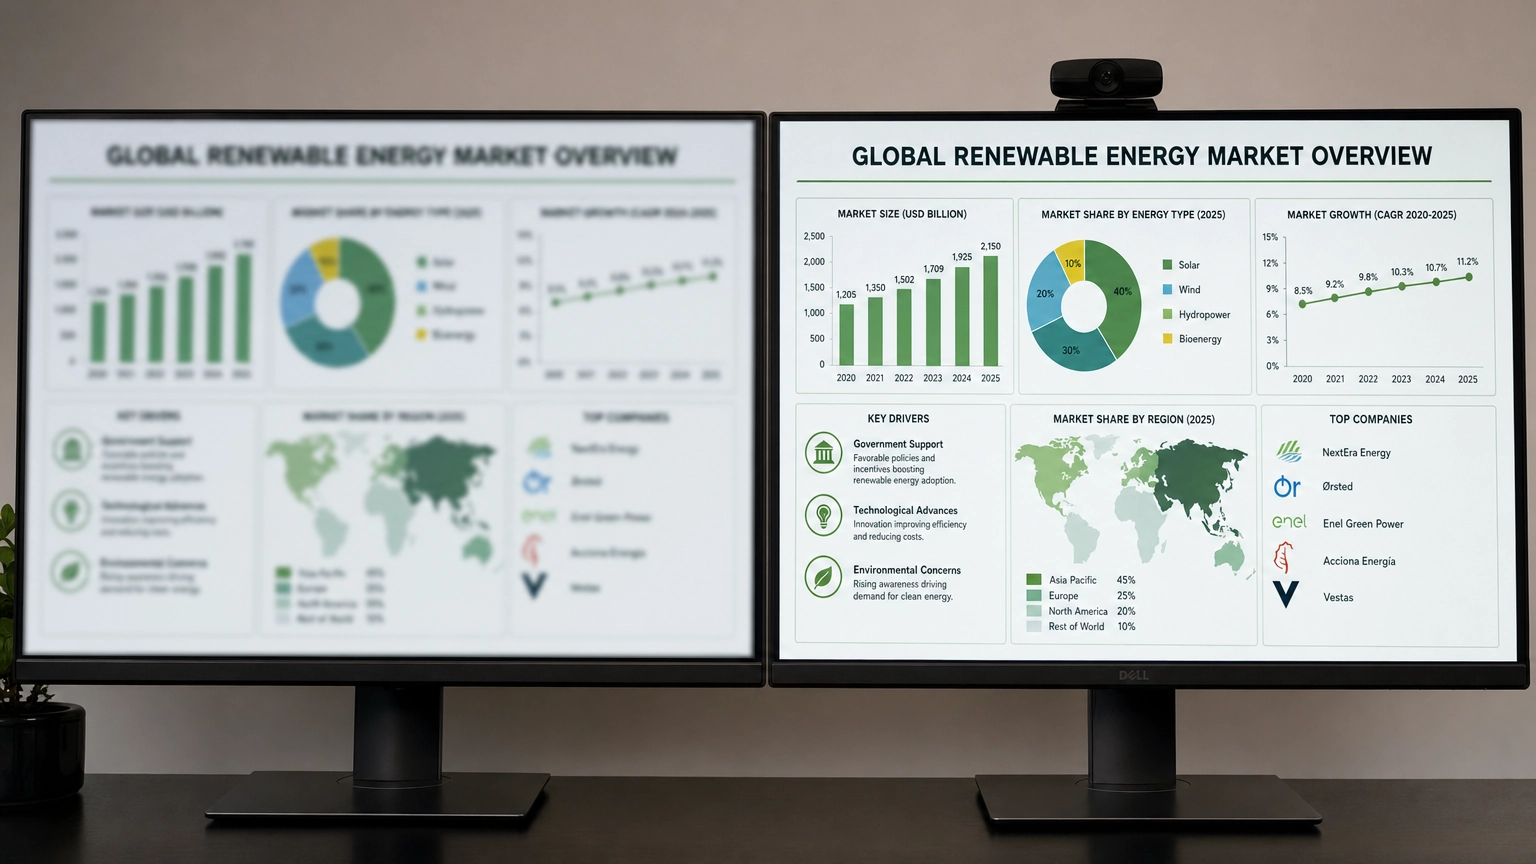
这个模型最突出的优势是处理图像内文本的能力。过去,混合脚本布局(即结合多种书写系统,如拉丁文和日文,或阿拉伯文和英文的设计)几乎会让市场上所有的商业模型都出错。而这个模型在这种情况下能生成可用的结果,这为多语言内容团队、国际营销和全球产品设计带来了真正的机遇。
除了文本处理,当你的图像需要作为一件设计素材而不仅仅是一张漂亮图片时,它也表现出色。可以考虑以下这些具体用例:
- 产品构图: 干净、光线充足的产品图片,对位置和背景有明确要求。
- UI 样机: 带有清晰标签的应用程序界面截图或线框图。
- 信息图表: 数据驱动的视觉效果,其中数字和标签必须准确且可读。
- 视频首帧: 为特定宽高比设计的缩略图或开场画面。
- 营销物料: 包含标题、行动号召 (CTA) 和品牌化布局结构的广告创意。
如果你已经在使用 AI 图像编辑工具来优化其他生成器的输出,这个模型可能会减少你所需的后期处理工作,尤其是在文本校正和布局调整方面。
专家们一致指出的一个要点是:它偏爱精确的简报。当你清晰地定义任务、指明格式、说明目的并描述成功标准时,这个模型往往能准确地把握结构。与写得好的设计简报相比,仅使用关键词链或模糊的风格描述会产生更差的结果。
在投入使用前你需要了解的利弊权衡
没有哪个模型是完美的,这个模型也有一些实际的局限性,在你围绕它构建工作流之前,这些局限性值得了解。
“思考模式”会增加延迟。 因为模型在生成前需要对你的提示词进行推理,所以它比大多数竞争工具耗时更长。对于一次性的营销素材或客户演示作品,这点等待时间通常可以接受。但对于需要快速生成数十或数百张图像的批量生成任务,这种延迟会成为一个实实在在的生产力问题。
不支持透明背景。 自发布之日起,Responses 图像生成工具选项就不支持透明背景。对于产品摄影师、UI 设计师以及任何需要在不手动移除背景的情况下将图像放入现有布局中的人来说,这是一个重大缺陷。
为精确而生,而非为探索。 如果你是一位习惯于生成 50 个变体再从中挑选最佳方案的创作者,你可能会觉得它较慢的输出节奏令人沮丧。那些优先考虑速度和多样性的工具,比如我们下面将介绍的一些替代品,可能更适合这类工作流。
对提示词的依赖度高。 偏爱优质简报的另一面是,糟糕的简报会产生令人失望的结果。你不能指望这个模型像一些解释性更强的生成器那样填补创意空白。你需要带着清晰的构想来使用它。
与其他主流模型的比较
下面简要分析一下它与其他流行的 AI 图像生成选项的对比情况:
| 功能 | GPT Image 2 | Midjourney v7 | Stable Diffusion 3.5 | Nano Banana 2 |
|---|---|---|---|---|
| 文本渲染 | 极佳 | 一般 | 差 | 极佳 |
| 推理/规划 | 是 (内置) | 否 | 否 | 是 (可配置的思考级别) |
| 透明背景 | 否 | 否 | 是 (需借助工具) | 否 (仅有第三方解决方案) |
| 生成速度 | 慢 (思考模式) | 快 | 快 | 快 |
| API 访问 | 是 | 有限 | 是 | 是 |
| 最佳用例 | 设计素材,重文本内容 | 艺术性、美学创作 | 自定义/技术工作流 | 快速生成重文本内容,主体一致性强 |
| 定价模型 | ChatGPT 订阅 / API | 订阅制 | 免费/开源 | API,按图像付费 |
DALL-E 3 已从本比较中移除。OpenAI 于 2026 年 5 月 12 日停用了 DALL-E 2 和 DALL-E 3。GPT Image 2 是其直接的继任者。
GPT Image 2 和 Nano Banana 2 是这里唯二拥有推理层的模型,但它们在此功能上做出了截然不同的取舍。GPT Image 2 的“思考模式”始终开启,这会减慢生成速度。而 Nano Banana 2 的思考级别是可调节的,因此当你不需要额外的推理步骤时,可以选择牺牲精度来换取速度。
如果你正在寻找一个优先考虑精度和文本准确性而非风格多样性的 Midjourney 替代品,那么它是一个强有力的候选者。然而,如果你的工作更具艺术性和探索性,Midjourney 在美学方面的优势可能仍然更胜一筹。
对于希望在一个地方访问多个模型的用户,浏览更广泛的 模型库 可以帮助你在为工作流选择特定工具之前,并排比较不同模型的输出结果。
如何充分利用这个模型
如果你决定将这个模型整合到你的创意或营销工作流中,有几个实用的习惯可以显著提升输出质量。
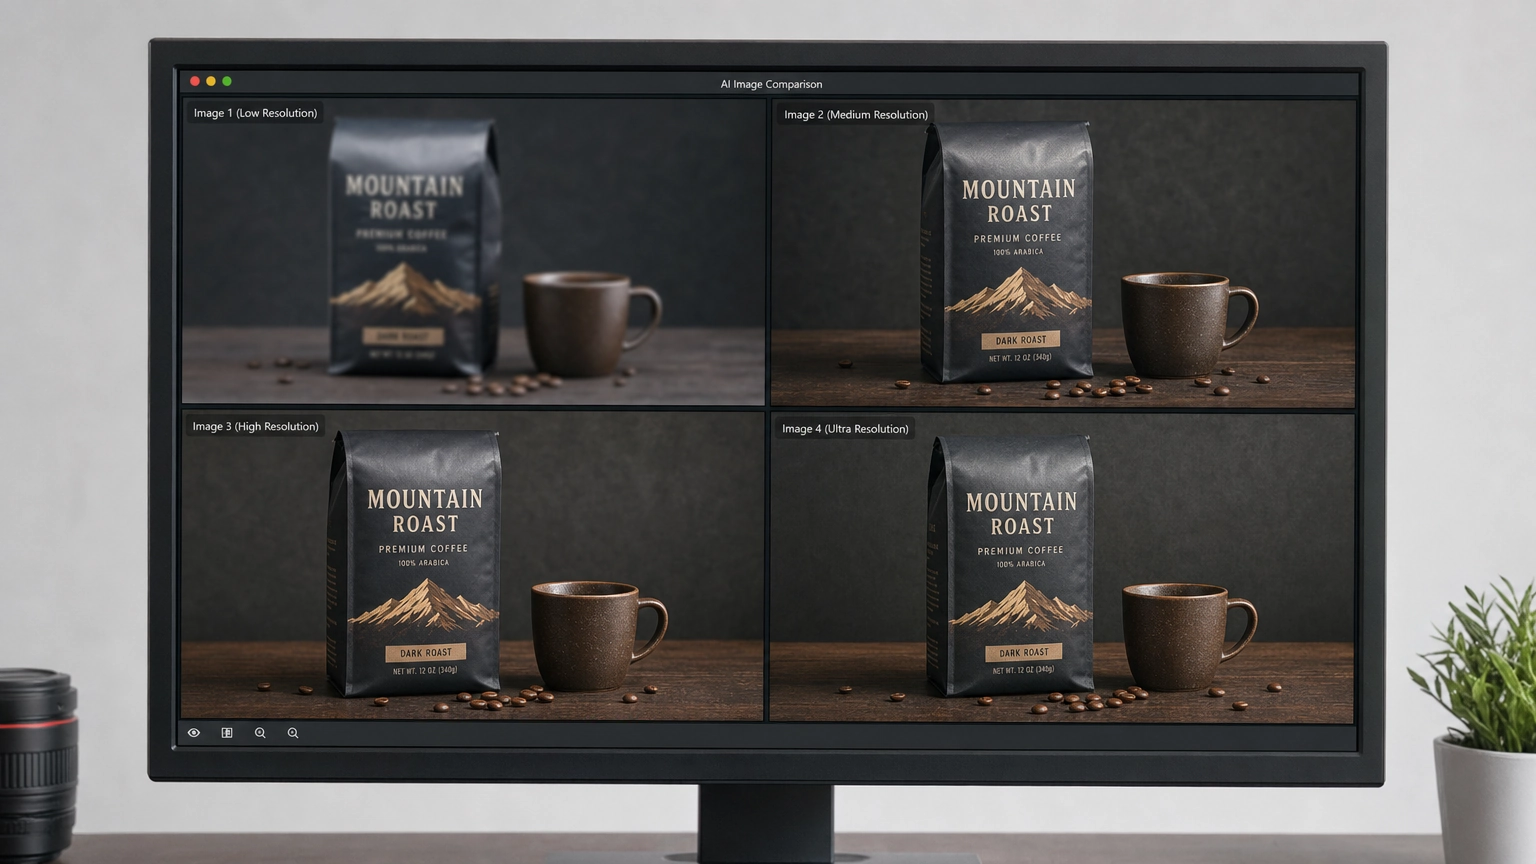
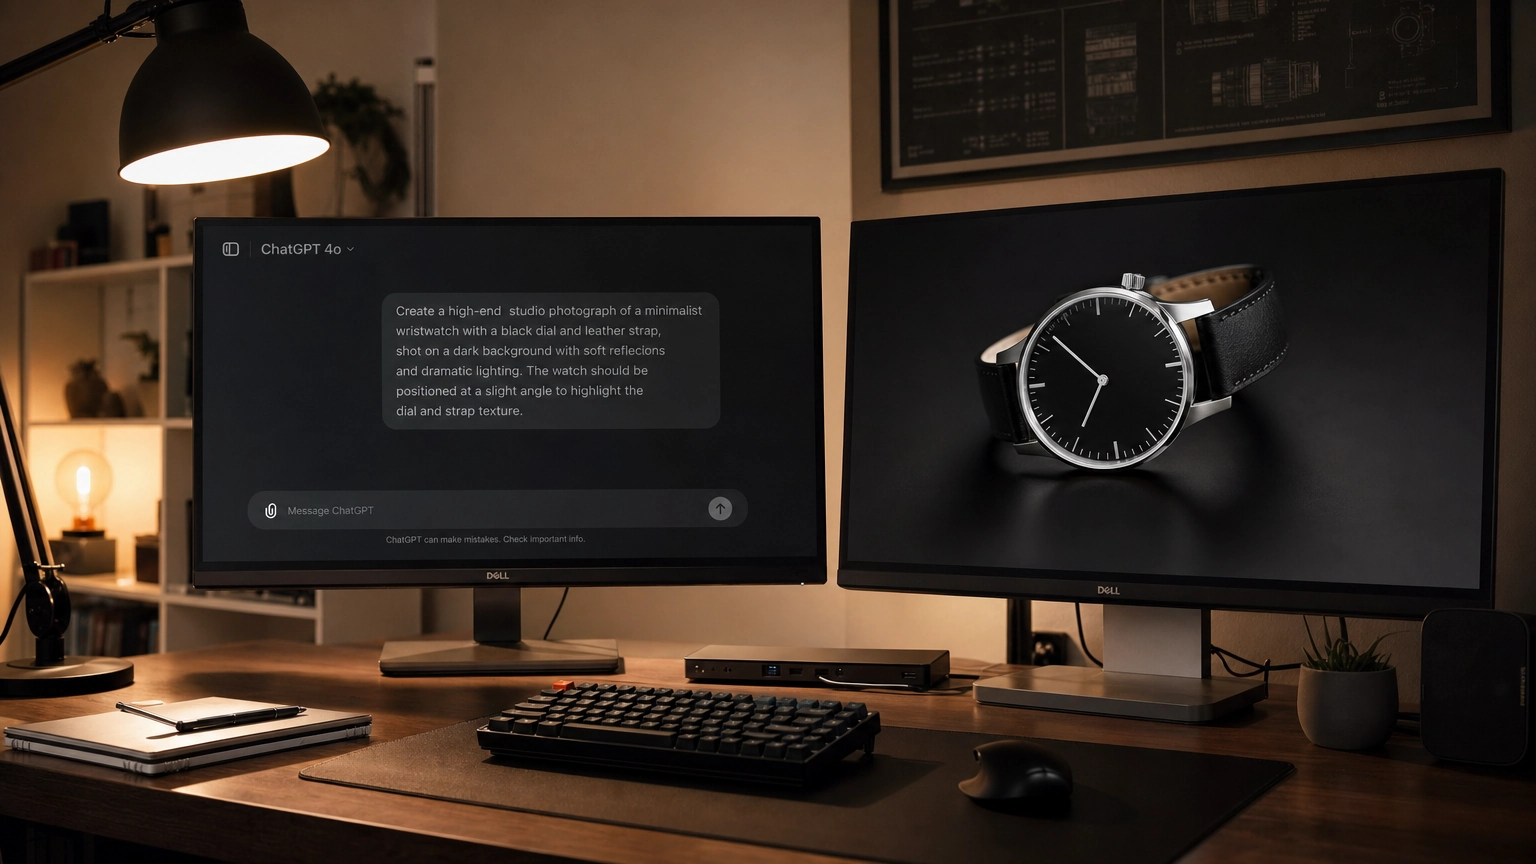
像写设计简报一样写提示词。 不要只写“白色背景上的一瓶水”,而是尝试这样写:“一个透明玻璃水瓶,位于纯白背景中央,产品摄影风格,柔和的漫射光从左上方射入,专为 1000x1000px 的电商列表设计。” 第二个提示词给了模型一个任务、一种格式和一个成功标准。
用它来生成最终阶段的素材。 由于存在延迟,它最适合用于创意流程的末端,而不是开端。勾画你的概念草图,获得客户对方向的认可,然后再用它来生成精细且文本准确的最终成品。
单独规划背景移除工作。 在透明背景功能上线之前,需要预留时间使用 Adobe Photoshop 的“移除背景”功能或专门的应用程序来手动移除背景。
与其他生成器结合使用以获得多样性。 考虑使用更快的模型进行初步探索和概念开发,然后在需要一个文本和布局都完全正确的版本时,再使用这个模型。
如果你在决定订阅前想测试这个模型,了解实际的成本数据会很有帮助。ChatGPT 的免费版每天限制你生成 2 到 3 次。Plus 版则将上限提高到每 3 小时大约 50 张图片,每月固定费用 20 美元,无论你生成 5 张还是 500 张图片。在 Fiddl.art 上,使用 GPT Image 2 生成一张图片需要 20 个积分(按标准费率约合 0.20 美元),没有每日上限,也无需订阅。公开生成作品,Fiddl.art 的 Missions 系统会随着时间的推移返还部分费用,一旦你完成一些生成里程碑,每张图片的有效成本将接近 0.16 至 0.175 美元。这只适用于公开发布的作品,不包括私有作品。对于大多数每周只生成几张图片而不是每天几十张的人来说,按量付费比固定的月度套餐更划算,而且没有免费版的每日限制。
你可能还想关注一些新的挑战者模型,例如 Nano Banana 2 和 Seedream 4.5,根据你的具体输出要求,它们都值得拿来与 GPT Image 2 进行基准测试。
须知事项
- 它于 2026 年 4 月 21 日发布,随着全球用户获得访问权限,第二天就达到了使用高峰。
- 该模型原生集成于 ChatGPT(品牌名为 ChatGPT Images),也通过 OpenAI 的 API 提供,并正陆续推广到 Microsoft Copilot 和 Apple Intelligence。
- 根据早期使用数据,纵向格式是目前最常见的输出格式,占所有生成图像的一半以上。
- “思考模式”是其独特之处,但在发布时无法关闭以加快生成速度。
- 标准的 Responses 工具不支持透明背景,这是一个已知的局限性,对产品和 UI 设计师有影响。
- 当给予结构化、目标明确的提示词时,它的效果最好,而不是松散的创意性描述。
准备好在你当前的工作流中测试它了吗?
要评估这个模型是否适合你的需求,最好的方法是将其用于你正在进行的真实项目中。拿一个你以前用过的设计简报,包含文本元素、特定布局和明确的输出格式,然后用它和你当前使用的工具并行生成相同的素材。这种并排比较比任何基准测试都更有说服力。如果文本准确性和布局精度在你的工作中至关重要,那么结果可能会让你感到惊讶,尤其是与那些仅依赖提示词技巧的如何让 AI 图像看起来逼真的方法相比。
常见问题解答
问:GPT Image 2 可以免费使用吗?
可以,但在 ChatGPT 和 Fiddl.art 上都有严格的限制。
ChatGPT 的免费版每天为你提供 2 到 3 次生成机会,这个 24 小时窗口从你的第一次请求开始计算,而不是在午夜重置。ChatGPT Plus(每月 20 美元)将 chatgpt image generator 的限制提高到大约每 3 小时 50 张图片,但上限并未完全消失,而且无论你用不用,都得支付这笔固定费用。Fiddl.art 则省去了订阅环节:注册即送 60 个免费积分,之后按量付费,每张图片 0.20 美元,没有每日上限。
问:它与 DALL-E 3 有何不同?
它增加了一个 DALL-E 3所不具备的内置推理层。
DALL-E 3 是直接将提示词转换为图像,而这个模型在生成前会进行规划、搜索参考并自我检查。这使得它在文本渲染和结构化布局方面表现得明显更好。
问:它能生成透明背景的图片吗?
不能,目前通过 Responses 图像生成工具还无法支持透明背景。
这是发布时的一个已知局限。需要透明 PNG 图像的设计师在生成后需要使用单独的背景移除工具。
问:什么样的提示词效果最好?
详细、目标明确的提示词能产生最佳效果,这类提示词描述了图像的用途、格式和成功标准。
与其把它想象成描述一个场景,不如把它看作是在编写一份设计简报。包括预期用途、尺寸、必须出现的文本以及任何风格要求。
问:与其他模型相比,它的速度如何?
由于其“思考模式”的推理过程,它比大多数竞争模型都要慢。
对于单个高质量的输出,等待时间是可接受的。但对于批量生成或快速迭代的工作流,与 Midjourney 或标准 Stable Diffusion 流程等更快的工具相比,额外的延迟可能会成为瓶颈。
关于 GPT Image 2 的总结
它并不试图成为市场上速度最快或风格表现力最强的图像生成器。它的定位是最精确的那个,而对于结构化、重文本、专业设计的输出,它确实兑现了这一承诺。其推理架构真正改变了 AI 生成设计素材的可能性,特别是对于那些需要逼真照片提示词、跨多语言内容和对布局要求严苛的工作,需要保持一致质量的场景。
如果你的工作流程涉及大量图像内文本、复杂构图,或者交付成果需要看起来像是出自真正设计师之手而非随机的 AI,那么这个模型就应该在你的工具箱里占有一席之地。从一个真实的项目开始,写一份正式的简报,看看它能生成什么。结果会告诉你它究竟适合用在何处。