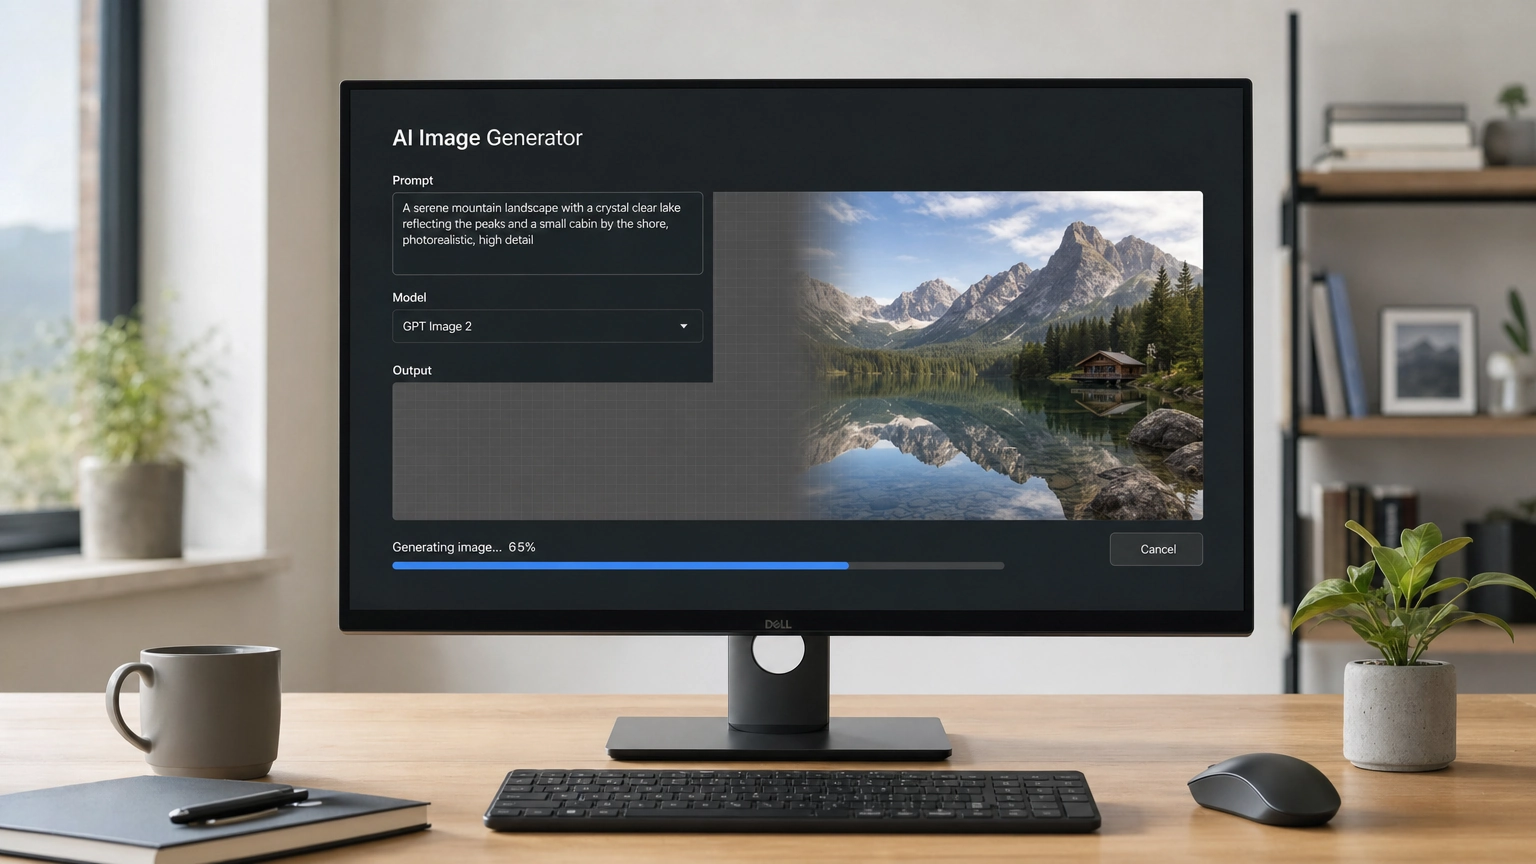
2026年4月21日にリリースされたGPT Image 2は、OpenAIの最新AI画像生成モデルであり、OpenAI初の推論機能を内蔵した画像モデルです。レイアウトを計画し、ウェブを参照し、最終結果を生成する前に自身の出力をチェックすることで画像を生成します。
この記事のポイント
- このモデルは「思考モード」を利用し、生成前に計画、検索、自己チェックを行います。これにより、以前のモデルよりもはるかに高い精度を実現しています。
- テキストの描画性能が劇的に向上し、複数の文字体系が混在する多言語レイアウトでも、実用的でプロフェッショナルな結果が得られるようになりました。
- クリエイティブな探求のためのエンジンというより、デザインアセットを作成するツールとして最も効果を発揮します。曖昧なプロンプトでは、あまり良い結果は得られません。
- 思考モードは顕著な遅延(レイテンシ)を生じさせるため、大量生成やバッチ処理のワークフローにはあまり実用的ではありません。
- 初期のユーザー出力では縦長(ポートレート)の向きが53.5%を占めており、ソーシャルメディアや縦型コンテンツ形式での利用が進んでいることがうかがえます。
- ChatGPTにネイティブで搭載されているほか、API経由でも利用可能で、Microsoft CopilotやApple Intelligenceへの展開も進んでいます。
このモデルが他と違う理由
ほとんどのAI画像モデルは、テキストプロンプトを受け取ると即座にピクセルに変換します。しかし、このモデルは違います。内蔵された推論レイヤーを持つ自己回帰型アーキテクチャを採用しており、これは生成前に「考える」ことを意味します。レイアウトを計画し、視覚的な正確性のためにウェブ上の情報を参照し、ユーザーが目にする前に出力を自己チェックすることができるのです。
この「思考モード」は、AI画像生成の仕組みにおける意義深い変化です。単に言葉を視覚的な出力にパターンマッチングさせるだけでなく、プロンプトをデザインの要件(ブリーフ)として扱い、それを解決しようとします。そのため、構造化された、精度が求められるユースケースで非常に強力な性能を発揮します。
初期の利用状況の数値は、実際の関心の高さを反映しています。リリースから数日間の6日間のデータ収集期間で、Twitter/Xから27,662件の画像レコードが収集されました。利用のピークはローンチ翌日の4月22日で、各タイムゾーンのユーザーがアクセスし始めた時期です。出力画像の向きは、縦長が53.5%、横長が38.0%、正方形が8.6%でした。また、画像の59.2%に顔が含まれており、人々がポートレートやマーケティングコンテンツ、人間中心のデザインに多用していることがわかります。
最も性能を発揮する場面
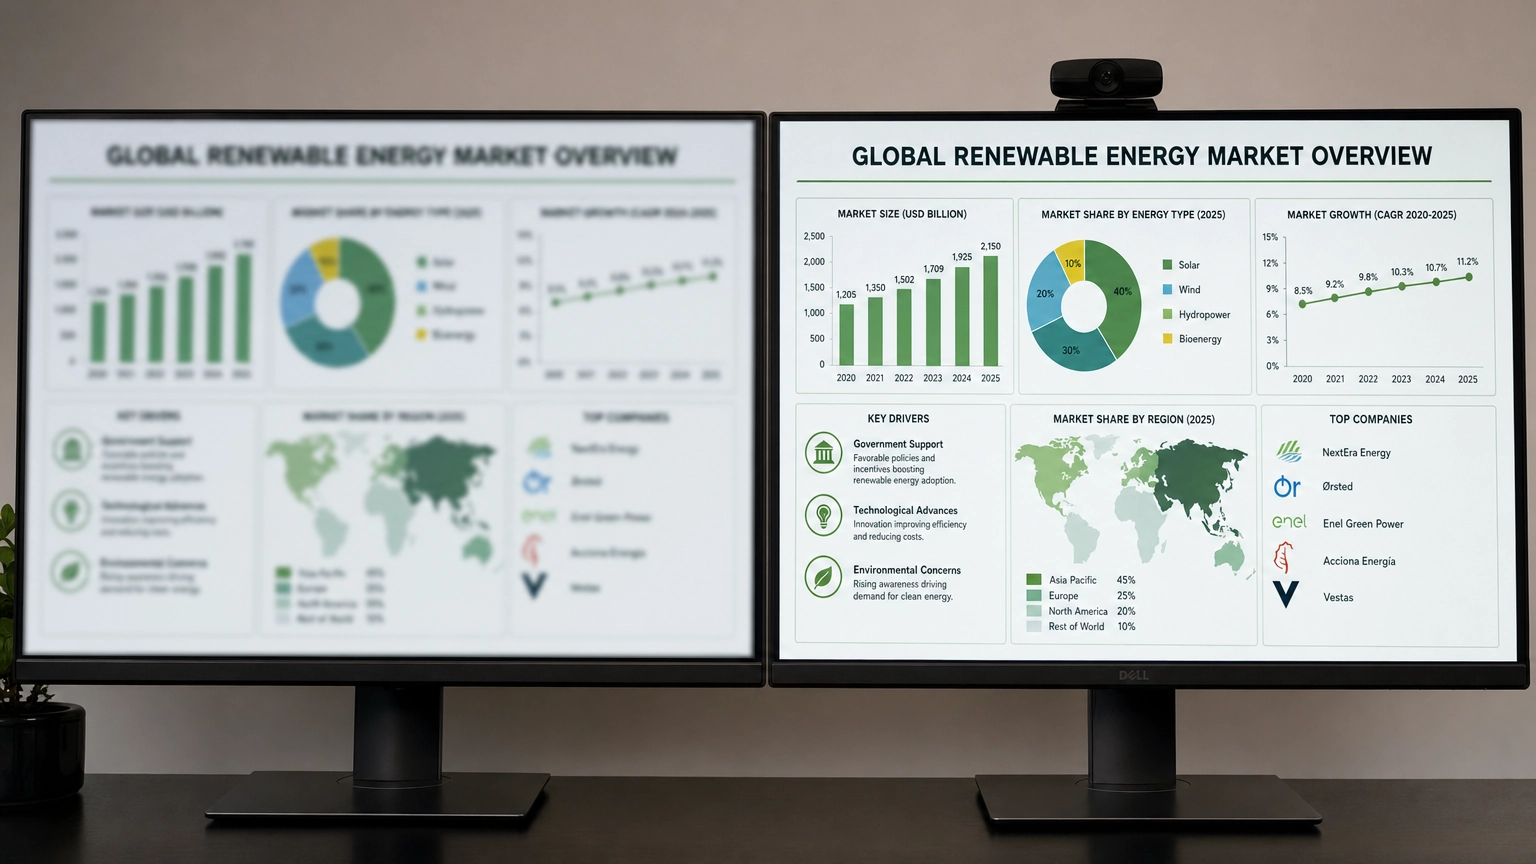
このモデルの最も明確な強みは、画像内のテキストを処理する能力です。ラテン文字と日本語、あるいはアラビア語と英語のように、複数の書記体系を組み合わせたデザインは、これまで市場に出回っているほとんどの商用モデルを悩ませてきました。このモデルは、そうした場合でも実用的な結果を生み出すため、多言語コンテンツチーム、国際的なマーケティング、グローバルな製品デザインに新たな可能性を開きます。
テキスト以外では、単なる美しい絵ではなく、デザインされたアセットとして機能する必要がある画像で優れた性能を発揮します。具体的なユースケースとしては、以下のようなものが考えられます。
- 製品の構図: 配置や背景が重要な、クリーンで明るい製品画像。
- UIモックアップ: ラベルが読みやすいアプリのインターフェーススクリーンショットやワイヤーフレームのビジュアライゼーション。
- インフォグラフィック: 数字やラベルが正確で読みやすい必要がある、データに基づいたビジュアル。
- 動画用の最初のフレーム: 特定のアスペクト比に合わせてデザインされたサムネイルやオープニングフレーム。
- マーケティング素材: 見出し、CTA(行動喚起)、ブランドのレイアウト構造を持つ広告クリエイティブ。
すでに他のジェネレーターからの出力を洗練させるためにAI画像編集ツールを試しているなら、このモデルを使えば、特にテキストの修正やレイアウト調整に関する後処理の作業を減らせるかもしれません。
専門家たちが一貫して指摘していることの一つに、このモデルは「詳細な指示に応える」という点があります。タスクを明確に定義し、フォーマットを指定し、目的を説明し、成功の形を描写すると、このモデルは構造を正確に捉える傾向があります。キーワードの羅列や曖昧な美的表現では、よく書かれたデザインブリーフに比べて質の低い結果になります。
導入前に知っておくべきトレードオフ
完璧なモデルはなく、このモデルにもワークフローに組み込む前に理解しておくべき現実的な制約があります。
思考モードは遅延(レイテンシ)を伴う。 モデルがプロンプトを解釈してから生成するため、競合するほとんどのツールよりも時間がかかります。単発のマーケティングアセットやクライアントへのプレゼンテーション用の素材であれば、その待ち時間は通常許容範囲内です。しかし、数十、数百の画像を迅速に必要とするバッチ生成ジョブでは、この遅延は生産性を妨げる現実的な問題となります。
背景透過に対応していない。 リリース時点で、画像生成ツール「Responses」のオプションでは背景透過をサポートしていません。これは、製品写真家やUIデザイナー、既存のレイアウトに画像をドロップする必要がある人にとって、大きな欠点です。
探求ではなく、精度を目的としている。 50個のバリエーションを生成して最適なものを選ぶタイプのクリエイターは、出力ペースの遅さに不満を感じるかもしれません。速度と多様性を優先するツール、例えば後述するいくつかの代替ツールの方が、そうしたワークフローには依然として適している場合があります。
プロンプトへの依存度が高い。 良い指示に応えることの裏返しとして、悪い指示では期待外れの結果になります。より解釈的な他のジェネレーターのように、クリエイティブなギャップをモデルが埋めてくれることには期待できません。明確なビジョンを持って使う必要があります。
他の主要モデルとの比較
他の人気AI画像生成オプションと比べてどうなのか、簡単にまとめてみました。
| 機能 | GPT Image 2 | Midjourney v7 | Stable Diffusion 3.5 | Nano Banana 2 |
|---|---|---|---|---|
| テキスト描画 | 非常に優れている | まあまあ | 苦手 | 非常に優れている |
| 推論/計画 | あり(内蔵) | なし | なし | あり(思考レベルを調整可能) |
| 背景透過 | 不可 | 不可 | 可(ツール使用) | 不可(サードパーティ製ツールでのみ対応) |
| 生成速度 | 遅い(思考モード) | 速い | 速い | 速い |
| APIアクセス | あり | 限定的 | あり | あり |
| 最適な用途 | デザインアセット、テキストの多いコンテンツ | 芸術的、審美的な作品 | カスタム/技術的なワークフロー | テキストの多いコンテンツの高速生成、被写体の一貫性 |
| 料金モデル | ChatGPTサブスクリプション / API | サブスクリプション | 無料/オープンソース | API、画像ごとの支払い |
DALL-E 3はこの比較から除外しました。OpenAIは2026年5月12日にDALL-E 2とDALL-E 3を廃止しました。GPT Image 2はその後継モデルです。
GPT Image 2とNano Banana 2は、ここで紹介するモデルの中で唯一推論レイヤーを備えていますが、その実装におけるトレードオフは対照的です。GPT Image 2の思考モードは常時オンで、生成速度を低下させます。一方、Nano Banana 2の思考レベルは調整可能で、追加の推論ステップが不要な場合は、精度よりも速度を優先することができます。
文体の多様性よりも精度とテキストの正確性を優先するMidjourneyの代替ツールを探しているなら、これは有力な候補です。しかし、あなたの仕事がより芸術的で探求的なものであれば、Midjourneyの審美的な強みが依然として優位かもしれません。
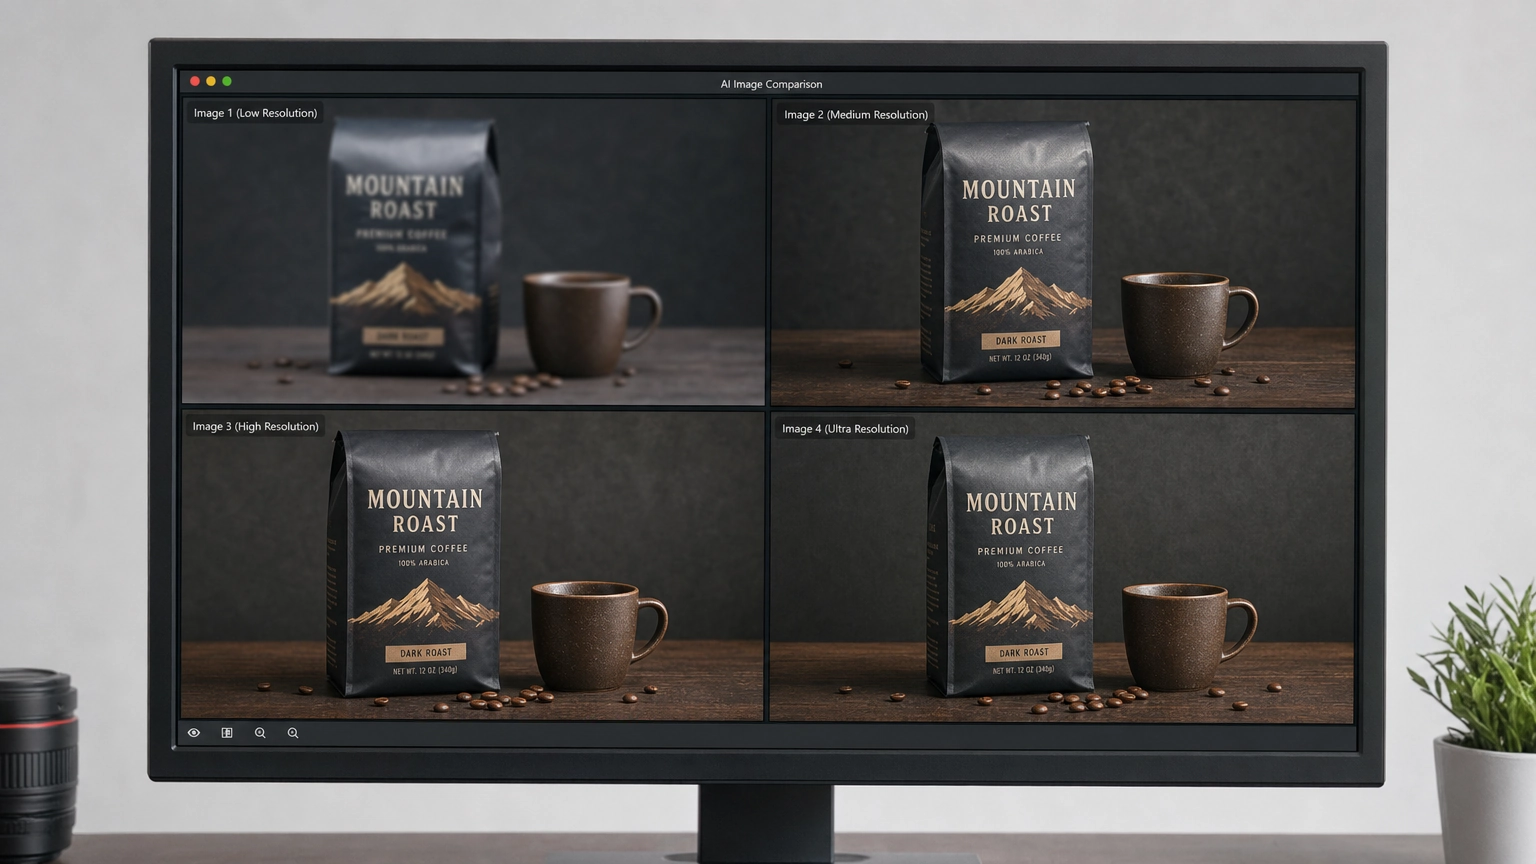
複数のモデルを一つの場所で利用したいユーザーにとっては、より広範なモデルライブラリをチェックして、特定のツールをワークフローに導入する前に出力を並べて比較するのに役立ちます。
このモデルを最大限に活用するために
このモデルをクリエイティブやマーケティングのワークフローに導入すると決めたなら、出力の質に大きな違いをもたらすいくつかの実践的な習慣があります。
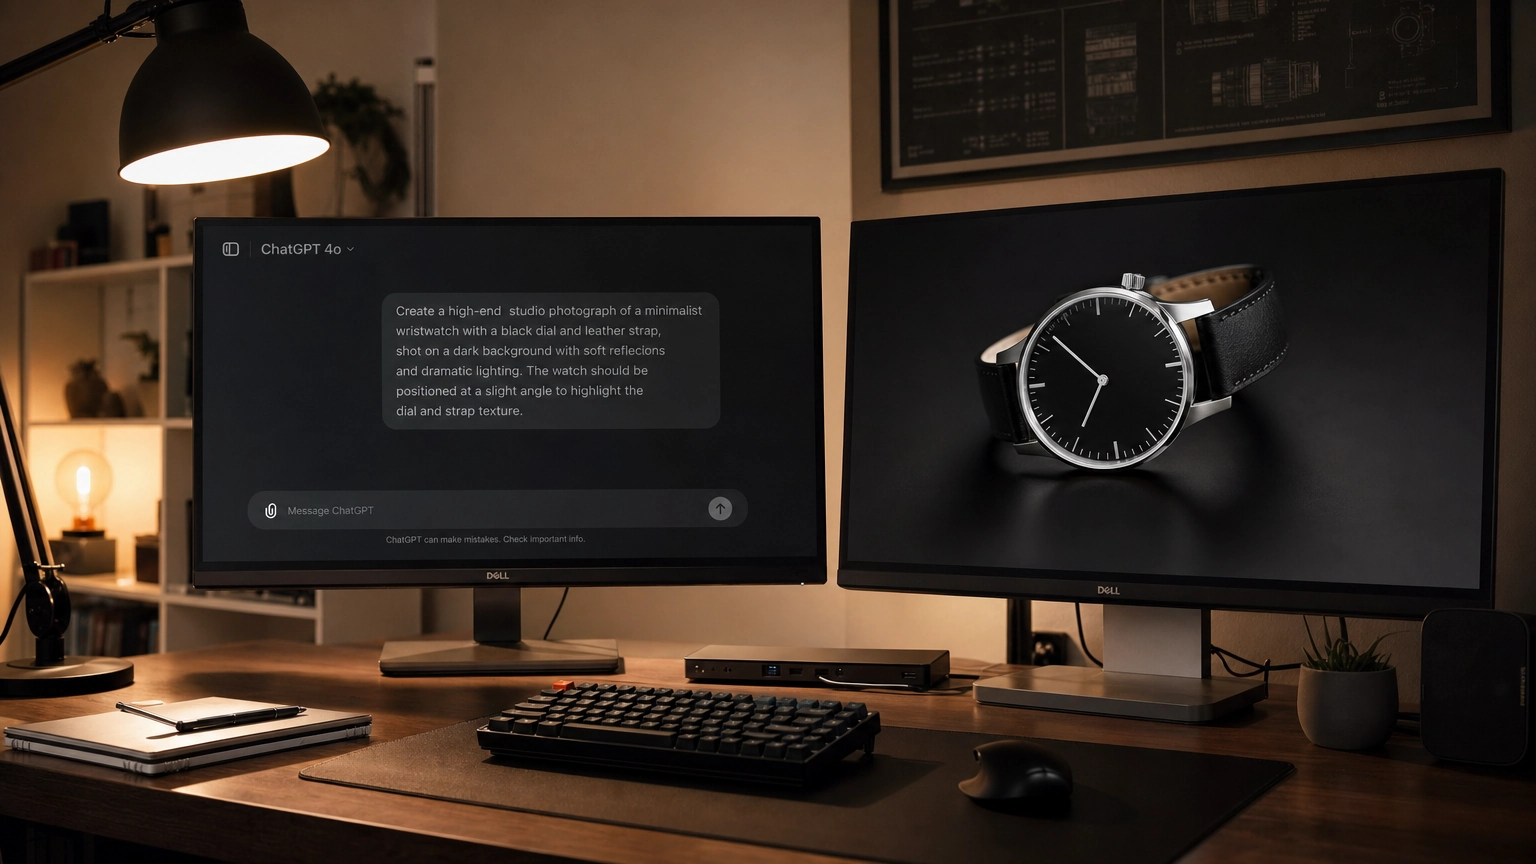
デザインブリーフのようにプロンプトを書く。 「白い背景に水のボトル」ではなく、「純白の背景の中央に配置された透明なガラスのウォーターボトル、製品写真スタイル、左上からの柔らかく拡散した照明、1000x1000pxのEコマース商品リスト用にデザイン」のように書いてみましょう。後者のプロンプトは、モデルにタスク、フォーマット、そして成功の条件を与えます。
最終段階のアセットに使う。 遅延があるため、クリエイティブプロセスの最初ではなく、最後で最も効果を発揮します。コンセプトをスケッチし、方向性についてクライアントの承認を得てから、このモデルを使ってテキストも正確な洗練された最終出力を生成しましょう。
背景除去は別で計画する。 背景透過がサポートされるまでは、Adobe Photoshopの「背景を削除」機能や専用アプリを使って手動で除去する時間を確保しておきましょう。
多様性のために他のジェネレーターと組み合わせる。 初期の探求やコンセプト開発にはより高速なモデルを使い、テキストとレイアウトを正確に再現する必要があるバージョンが必要になったときに、このモデルを投入することを検討してください。
サブスクリプションに契約する前にこのモデルをテストしているなら、実際の数字が参考になります。ChatGPTの無料プランでは、1日あたり2〜3回の生成に制限されます。Plusプラン(月額20ドル)では、この上限が3時間ごとに約50画像に増えますが、5枚生成しても500枚生成しても料金は変わりません。Fiddl.artでは、GPT Image 2は1画像あたり20クレジット(標準レートで約0.20ドル)で、日々の制限やサブスクリプションは不要です。公開設定で生成すると、Fiddl.artのミッションシステムにより一部が還元され、いくつかの生成マイルストーンを越えると実質的なコストは1画像あたり0.16ドルから0.175ドルに近づきます。これは公開作品にのみ適用され、プライベートな作品には適用されません。1日に何十枚もではなく、週に数枚の画像を生成するほとんどの人にとっては、定額の月額プランよりも従量課金制の方が安価で、無料プランのような日々の壁もありません。
また、Nano Banana 2やSeedream 4.5のような新しい挑戦的なモデルも、特定の出力要件に応じてベンチマークとして比較検討する価値があります。
知っておくべきこと
- 2026年4月21日にリリースされ、世界中のユーザーがアクセスできるようになった翌日に利用のピークを迎えました。
- このモデルはChatGPTにネイティブで搭載(ChatGPT Imagesとしてブランド化)されており、OpenAIのAPI経由でも利用可能です。Microsoft CopilotやApple Intelligenceへの展開も継続中です。
- 初期の利用データによると、縦長の向きが圧倒的に一般的な出力形式で、生成された全画像の半分以上を占めています。
- 思考モードがこのモデルを特徴づけていますが、リリース時点では生成を高速化するためにオフにすることはできません。
- 標準のResponsesツールでは背景透過はサポートされておらず、これは製品デザイナーやUIデザイナーに影響する既知の制限です。
- 漠然としたクリエイティブな説明よりも、構造化され、目標が明確なプロンプトを与えたときに最も効果を発揮します。
現在のワークフローと比べてテストしてみませんか?
このモデルがあなたのニーズに合うかどうかを評価する最善の方法は、実際に取り組んでいるプロジェクトで試してみることです。以前に使ったデザインブリーフ、つまりテキスト要素、特定のレイアウト、定義された出力形式があるものを取り上げ、現在使っているツールと並行して同じアセットを生成してみてください。並べて比較することで、どんなベンチマークよりも多くのことがわかるでしょう。もしあなたの仕事でテキストの正確性やレイアウトの精度が重要なら、特にプロンプトだけでAI画像をリアルに見せる方法のようなテクニックと比較した場合、その結果はあなたを驚かせるはずです。
よくある質問
Q: GPT Image 2は無料で利用できますか?
はい、ただしChatGPTとFiddl.artの両方で、実質的な制限があります。
ChatGPTの無料プランでは、1日あたり2〜3回の生成が可能です。この24時間の制限は、午前0時ではなく、最初のリクエストからリセットされます。ChatGPT Plus(月額20ドル)では、このchatgpt画像生成の上限が3時間ごとに約50画像に引き上げられますが、上限が完全になくなるわけではなく、利用するかどうかにかかわらず定額料金を支払うことになります。Fiddl.artはサブスクリプションを必要とせず、サインアップ時に60クレジットが無料で付与され、その後は1画像あたり0.20ドルの従量課金制で、日々の制限はありません。
Q: DALL-E 3とはどう違いますか?
DALL-E 3にはない、内蔵された推論レイヤーが追加されています。
DALL-E 3がプロンプトを直接画像に変換するのに対し、このモデルは出力を計画し、参照情報を検索し、生成前に自己チェックを行います。これにより、テキストの描画や構造化されたレイアウトにおいて、格段に優れた性能を発揮します。
Q: 背景が透明な画像を生成できますか?
いいえ、現在、Responses画像生成ツールでは背景透過はサポートされていません。
これはリリース時点での既知の制限です。透明なPNGが必要なデザイナーは、生成後に別途背景除去ツールを使用する必要があります。
Q: どのようなプロンプトが最も効果的ですか?
画像の目的、形式、成功基準を記述した、詳細で目標志向のプロンプトが最良の結果を生み出します。
単にシーンを描写するのではなく、デザインブリーフを書くように考えてください。意図する用途、寸法、表示すべきテキスト、およびスタイル上の要件を含めましょう。
Q: 他のモデルと比べてどのくらい速いですか?
思考モードによる推論プロセスがあるため、ほとんどの競合モデルよりも低速です。
単一の高品質な出力を求める場合、待ち時間は許容範囲です。しかし、バッチ生成や迅速なイテレーションを行うワークフローでは、Midjourneyや標準的なStable Diffusionパイプラインのような高速なツールと比較して、追加の遅延がボトルネックになる可能性があります。
GPT Image 2の総括
このモデルは、市場で最も速く、最も文体的に表現力豊かな画像ジェネレーターを目指しているわけではありません。最も「正確」なモデルとして自らを位置づけており、構造化され、テキストが多く、専門的にデザインされた出力に関しては、その約束を果たしています。推論アーキテクチャは、AIが生成するデザインアセットで可能なことの概念を真に変えます。特に、リアルな写真のプロンプトや、多言語コンテンツおよびレイアウトが重要な作業で一貫した品質が求められる場合に、その真価を発揮します。
もしあなたのワークフローに、画像内のテキスト、複雑な構図、あるいはランダムなAIではなく本物のデザイナーが作ったかのように見える成果物が多く含まれるなら、このモデルはあなたのツールキットに加えるべきです。まずは実際のプロジェクトで試し、適切なブリーフを書いて、何が生成されるかを見てみてください。その結果が、このモデルがどこにフィットするのかを正確に示してくれるでしょう。